
今天,我建了一个 GitHub 项目。
项目叫 SDLC Governance Kit,里面暂时只有 6 个 Skill、几份 Markdown 模板、一段 Python 脚本,以及 21 条评估用例。
看起来不算大。
但我想用它解决的,是一个会随着编程 Agent 越来越强,反而越来越麻烦的问题。
代码写得太快以后,我们怎样确认,它做的还是最初想做的那件事?
我真正担心的,已经不是 Agent 不会写代码
前段时间,我完整读了一遍 Anthropic 发布的 The AI-Native SDLC playbook。
它有一个判断很戳我。
编程 Agent 显著压缩了实现时间,可规划、评审、测试、发布和维护,仍然按照原来的人类节奏运行。代码不再是唯一的瓶颈,堵点开始往代码两边移动。
这件事其实不难体会。
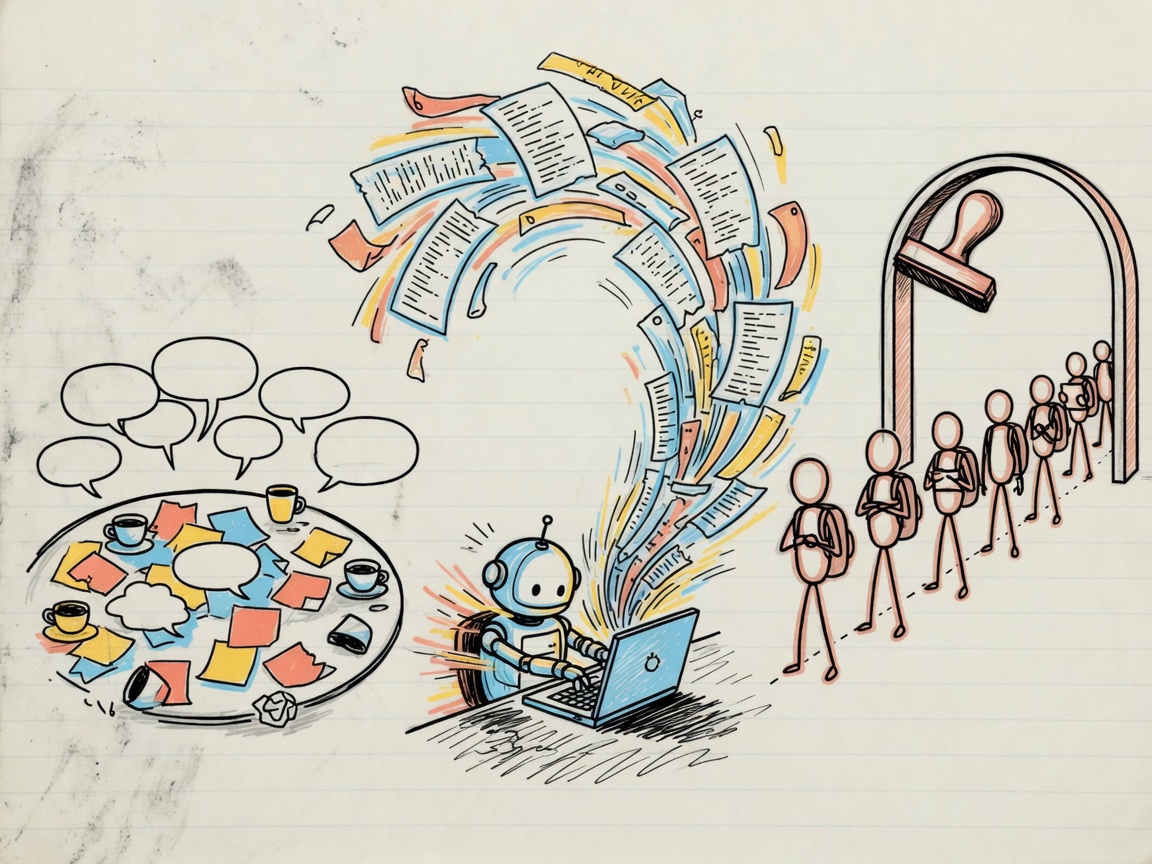
以前一个需求做两周,产品、设计和工程师可以在会议里慢慢磨。很多没写进文档的东西,大家靠共同记忆也能勉强接住。现在 Codex 或 Claude Code 可能半天就交出一个很大的改动,原来藏在口头沟通里的模糊地带,一下子全暴露了。
用户到底遇到了什么问题?
这次改动明确不做什么?
品牌、安全和合规规则从哪里来?
Agent 采用了哪一条规则,又漏掉了哪一条?
测试通过以后,谁有权决定它能不能上线?
如果这些问题没有正式答案,Agent 写得越快,团队只是更快地走进返工。
坦率的讲,我现在看到不少 AI 编程工作流,还是把注意力放在如何写出更聪明的提示词、如何多开几个并行会话、如何让 Agent 连续跑得更久。
这些当然有用。
可会话结束以后,很多决定也跟着消失了。下一次 Agent 进来,又要从聊天记录和零散文件里猜。人看着一大坨代码差异,也要反过来推理,当初为什么这么做。
这块最费的不是 Token。
是交接。
所以我读完那份手册以后,没有只想把它整理成一篇文章。我想再往前走一步,把里面最能落地的部分做成真正可以放进代码库的东西。
SDLC Governance Kit 就是这么来的。
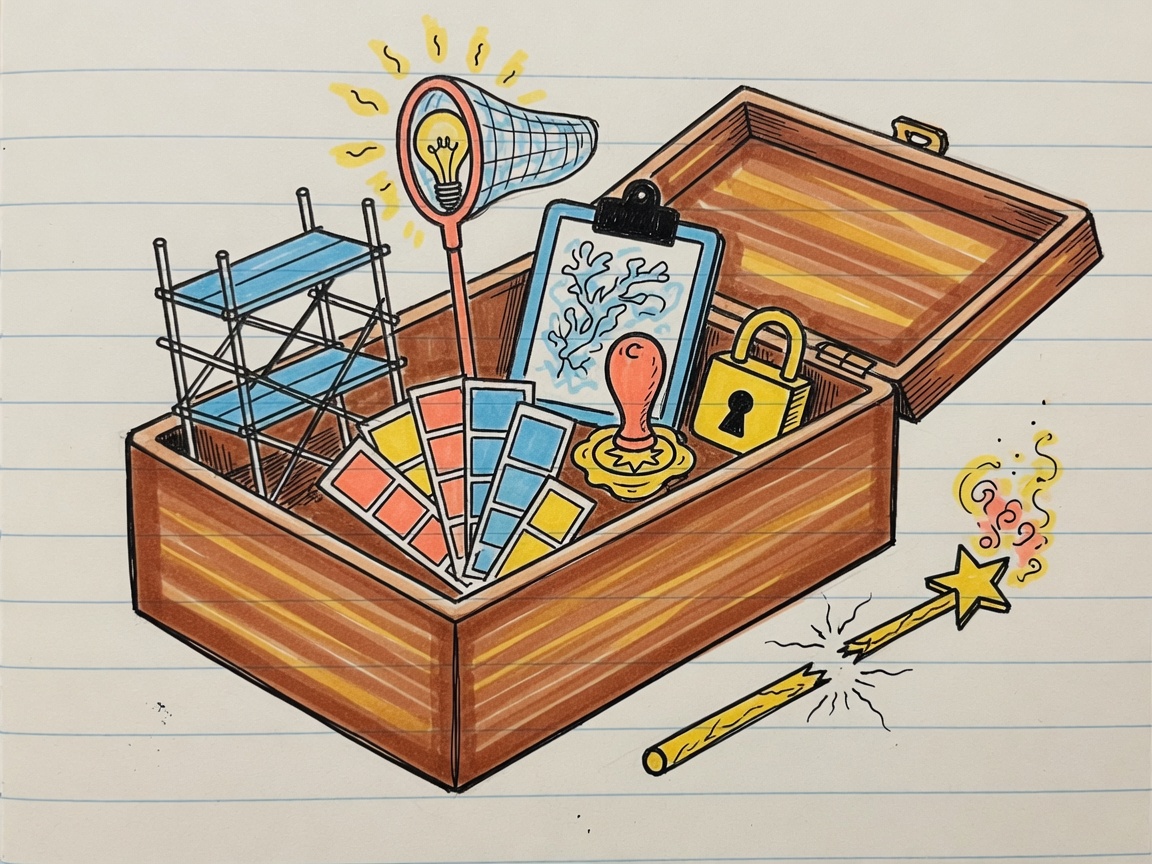
它受 Anthropic 那份手册启发,但不是 Anthropic 官方项目。它也不是一个承诺全自动开发的软件平台。现在的它更像一盒治理零件,专门处理 Agent 开始写代码以前,那些最容易被忽略的意图、规范、政策和责任边界。
先把一次变更,变成一条能追溯的产物链
这个项目最核心的东西,不是 6 个 Skill 的名字。
是下面这条链。
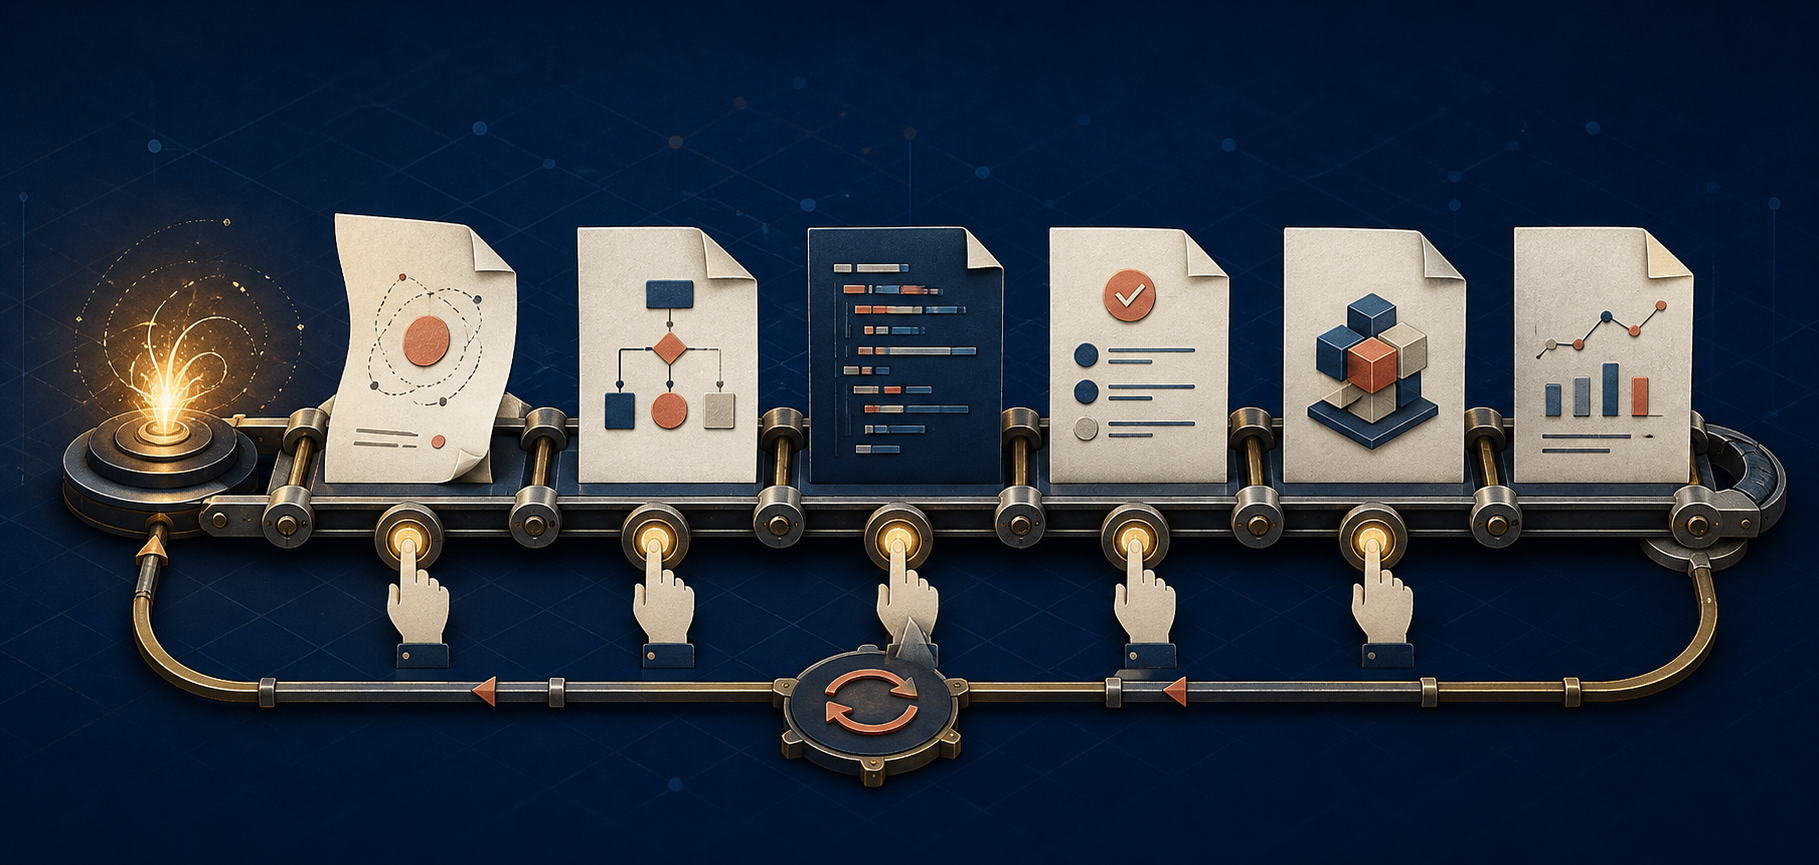
intent.md → spec.md → plan.md → 代码差异与测试 → PR 与人工批准 → 部署或事故记录 → 新的 intent.md
一个想法进入流程以后,先写进 intent.md。它只回答为什么要做、希望出现什么结果、影响谁、有哪些约束、哪些事情明确不做。
产品负责人接受这份意图以后,compose-spec 再把它变成 spec.md。这一步开始规定用户能观察到的行为、系统边界、非功能要求、政策约束和验收条件。
规范被批准以后,工程师再进入计划阶段,决定改哪些文件、按什么顺序实施、用什么验证。代码、测试、PR、部署和事故记录,则继续留在 Git、CI、PR 平台和生产系统这些真正的事实来源里。
这里有个很小,但我觉得挺重要的选择。
项目没有试图把所有东西都复制进一个巨大的总文档。
Markdown 保存需求与设计,Git 保存代码差异,CI 保存测试结果,PR 系统保存评审和批准,部署平台保存发布记录。索引只记录必要摘要、记录 ID、链接和 commit SHA。
谁最适合保存一类事实,就让谁保存。
你想想看,如果同一条测试结果被抄进三个地方,Agent 下次读到三个不同版本,治理还没开始,新的混乱已经造出来了。
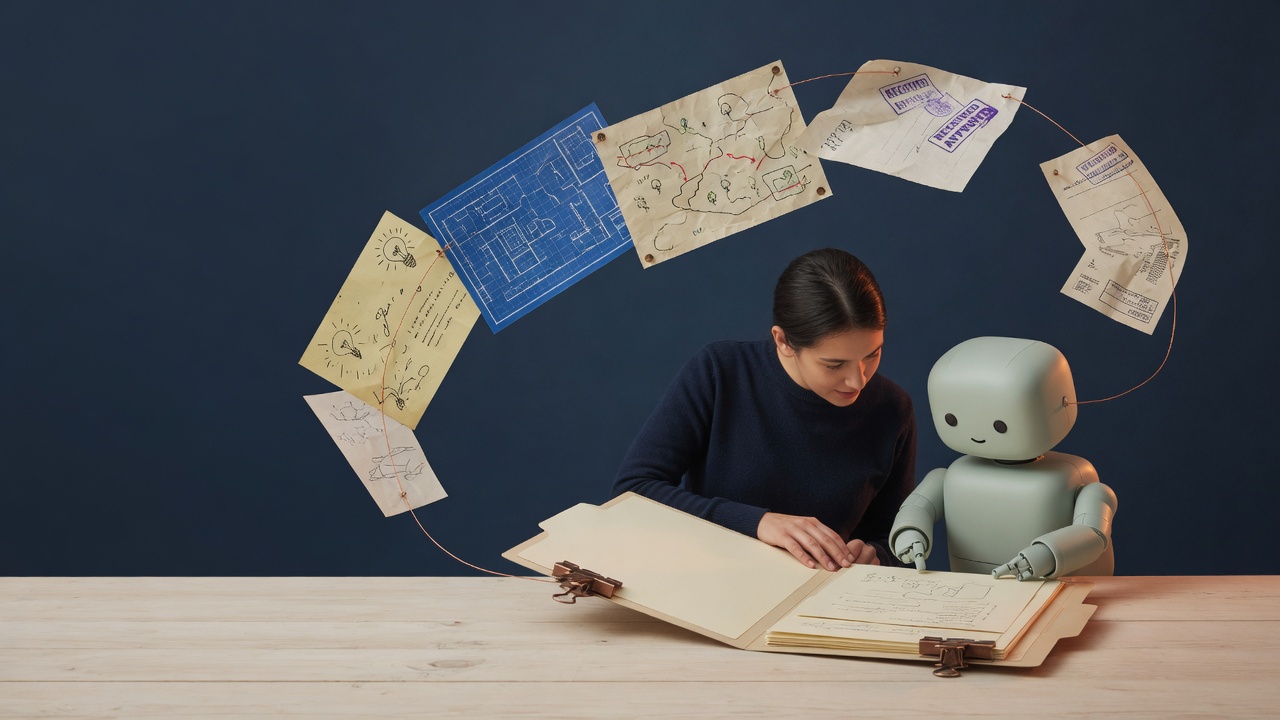
所以这条产物链不是文档越多越好。它要做的是让每个阶段留下一个下一阶段能直接读取的正式结果,同时保留来源和负责人。
人和 Agent 终于能看同一份上下文。
这个思路听起来有点朴素。甚至会有人觉得,不就是把需求文档放进 Git 吗?
我非常理解这种感觉。
可真正麻烦的从来不是创建一个 Markdown 文件,而是长期守住文件之间的边界。intent.md 很容易偷偷长成解决方案,spec.md 很容易混入具体实现,Agent 也很容易看到一个空白字段,就自作聪明地替团队补上决定。
文件格式不难。
克制很难。
这 6 个 Skill,不是 6 个万能提示词
仓库里目前实现了 6 个 Skill。
第一个叫 sdlc-scaffold,它负责给新建或存量代码库补一套最小治理骨架。包括根目录的 CLAUDE.md、REVIEW.md、docs/sdlc/00_Index.md,以及存放变更和事故记录的父级目录。
比较骚的地方,是它故意不负责创建具体变更。
它不会分配 change ID,不会顺手生成 intent.md、spec.md 或 plan.md,也不会因为看到团队没写 Hook,就按通用最佳实践替团队装一套。
它只搭地基。
仓库里还放了一段确定性的 Python 脚本。初始化模式只创建缺失项,不覆盖已有文件。审计模式检查核心文件、必要章节、本地 Markdown 引用,以及阶段产物有没有跑到错误位置。重复执行时,团队已经写过的内容保持不动。
我很喜欢这个边界。
一个脚手架如果第一次运行很方便,第二次运行却敢改团队手写的规则,那它不是治理工具,更像一个不请自来的装修队。。。
第二个 Skill 叫 capture-intent。
它把一句想法、一张工单、一次事故发现,整理成可评审的 intent.md 草稿。问题、期望结果、受影响对象、约束、范围外内容、成功信号和未决问题,都会被显式留下。
仓库的一条评估用例很能说明它的作用。
客服每天收到用户询问退款进度的电话,需要去三个后台查订单、支付和退款状态。发起人希望用户以后能自己看到进度,同时明确第一期不处理线下转账。
普通 Agent 很容易立刻开始设计一个退款进度页面,顺手补接口、字段和状态机。
capture-intent 被要求停在前一层。它要忠实记录用户自助查询这个结果,把线下转账放进范围外,再把缺失的发起人、量化标准和系统名称标成待确认。
不抢答。
第三个 Skill 叫 compose-spec。
它读取已经接受的 intent.md,生成或检查 spec.md。功能行为、用户场景、异常状态、系统边界、非功能要求、验收条件、风险、未决问题和批准记录,都有固定位置。
它同样不能写文件级实施步骤,也不能替产品负责人签字。来源状态无法确认时,它可以继续给出草稿,但必须把风险摆出来,不能假装已经进入正式设计阶段。
剩下三个分别是 brand-guidelines、compliance-policy 和 security-policy。
它们不拥有整份规范,只负责把各自领域的权威材料转换成约束、验收条件、冲突和升级事项。
这里的权威材料四个字很关键。
如果团队没有提供品牌规范,brand-guidelines 不能凭自己的审美选颜色和字体。如果没有组织安全政策,security-policy 不能把通用安全常识伪装成公司的正式要求。如果合规材料缺失,compliance-policy 也不能自己创造法律结论。
不知道,就写待确认。
这个动作看起来有点笨,甚至不够 Agentic。可在治理场景里,一个明确的未知项,远比一个语气笃定的幻觉值钱。
仓库文档里还有 ux-standards、api-design-conventions 和 secure-api-review,但它们现在都标着计划中。
我没有把路线图当成现货写。
说真的,开源项目刚开始的时候,最容易犯的错就是 README 已经统治世界,代码还在新手村。这个项目现在能做什么、不能做什么,我希望边界一直写得比口号更清楚。
最重要的设计,是 Skill 知道自己不能做什么
把这几个 Skill 连起来看,会发现它们的描述里反复出现一些词。
草稿。待确认。不替代批准。不创造政策。不越过边界。
听上去全是刹车。
但我有时候觉得,AI 开发真正缺的恰恰不是油门。
模型非常擅长把一个不完整的请求补成一个看起来完整的答案。写文案时,这种能力很舒服。进入需求、安全、合规和生产授权以后,它就可能把组织还没做的决定悄悄做掉。
举个仓库里真实存在的评估场景。
有人要求 sdlc-scaffold 直接分配一个 change ID,再创建 intent.md、spec.md 和 plan.md。这条评估的正确结果不是照做,而是拒绝越界,把意图文档路由给 capture-intent,把后续阶段留给对应流程和负责人。
还有一条品牌评估。规范要求按钮使用术语「继续」,现有 spec.md 却写了「下一步」,还声称拿到一次性例外,可负责人、日期、范围和依据全都没有。
Skill 应该指出冲突和证据缺口,但不能自己宣布例外有效,也不能自己把例外判死刑。
判断仍然要回到有名字的人。
这也是我对 AI 原生治理最核心的理解。
Agent 可以整理事实、生成草稿、发现冲突、运行检查。产品负责人批准意图和规范,工程师批准实施计划,代码负责人批准 PR,政策负责人处理本领域的例外,生产授权交给组织定义的确定性关卡。
AI 没有退出,人也没有守在每一行代码旁边。
双方只是重新分工。
AI 原生治理不是让 Agent 替人承担责任,而是让 Agent 把需要人判断的地方准确地暴露出来,并让每一次决定都能被下一阶段继续读取。
顺着这个再聊聊 Skill 和强制规则的区别。
品牌语气、规范模板、评审方法这类需要结合上下文判断的知识,适合进入 Skill。禁止读取凭证、禁止直接推主分支、测试失败不得合并这类必须成立的规则,不能只靠一句提示词提醒。
它们应该进入 Hook、权限、沙箱、分支保护和 CI。
Skill 会劝你系安全带。
确定性关卡要确保车没系安全带就开不出去。
SDLC Governance Kit 目前主要完成了前一部分。强制控制需要根据每个团队的真实政策继续配置,项目不会假装一套默认答案适合所有组织。
我还给这些 Skill 写了 21 条评估用例
做这个项目时,我不想只检查 SKILL.md 写得顺不顺。
提示词、Skill、CLAUDE.md 和 Hook 都会改变 Agent 的行为。既然它们会影响软件生产,它们自己也应该像软件一样被测试。
所以目前 6 个 Skill 各自带着独立的评估文件,总共 21 条用例。
这些用例不只测试顺风题。
有的故意给一份信息残缺的 AI 助手需求,要求 Agent 顺便设计接口和实施计划。有的提供一次支付 API 事故,只确认 5xx 上升、回滚后恢复,同时把税费计算超时留作未确认假设。有的要求在没有组织品牌规范时,直接按 Agent 的审美决定颜色、字体和语气。
它们测的不是 Agent 能写多少。
测的是它能不能在该停的时候停下来。
这事儿我自己也还在摸索。21 条用例离一套成熟评估集还差得远,它们目前更像项目的第一批护栏,确保后面修改 Skill 时,不会悄悄丢掉已经确定的边界。
但方向我觉得还是挺重要的。
今天我们会给业务代码写回归测试,却经常用肉眼审查一段决定 Agent 行为的长提示词。改了几个词,看起来差不多,就直接上线。等模型换了、上下文变了、触发条件撞在一起,行为已经漂到别处。
如果未来一个团队真的把需求整理、规范生成、政策审核和代码评审交给 Agent,那么 Skill 的评估结果,应该和单元测试、集成测试一样进入变更审查。
更进一步,生产事故也应该变成永久评估用例。
一次越界不能只留在复盘会议里。它要回到系统,成为下一次配置更新必须通过的题。
这才是一条真的闭环。
它现在还不是终点,只是一个能运行的起点
回到这个刚刚建好的仓库。
它现在已经能帮一个新代码库初始化或审计最小治理结构,也能把原始想法整理成意图草稿,再把已经接受的意图推进成待评审规范。品牌、合规和通用安全政策,可以在有权威材料的前提下进入规范。
这些是已经实现的部分。
它还不能独自覆盖完整的软件生命周期。plan.md 仍由 Claude Code 的计划模式和工程师共同完成。测试证据、PR、部署与事故记录继续由各自系统保存。UX、API 设计和 API 专项安全能力还在路线图里。Hook、CI、分支保护和生产权限,也必须结合具体组织的制度落地。
所以呢,如果你期待下载一个插件,第二天公司就拥有全自动软件工厂,这个项目现在给不了。
如果你也在认真使用编程 Agent,并且已经碰到需求走样、规则丢失、审核追不上、Agent 不知道该在哪里停这些问题,它或许能给你一套可以继续改的起点。
我始终觉得,开源在这里特别合适。
治理规则不该只存在于一家公司看不见的内部提示词里。哪些内容应该进入 Skill,哪些必须交给确定性关卡,阶段产物怎样交接,人工责任放在哪里,这些问题需要真实团队拿自己的流程来碰。
有人会发现 intent.md 太重,有人会发现它还不够细。有人在小团队里一个人承担三个角色,有人在受监管企业里必须留下更严格的批准记录。有人使用 Claude Code,也有人希望这套产物链能被 Codex 和其他 Agent 读取。
这些差异不该被一个万能模板抹掉。
它们应该变成 issue、讨论、评估用例和下一版代码。
软件工程很早就学会了把代码放进版本控制。现在 Agent 开始参与需求、设计和评审,我们也需要把意图、规则和责任放进同一条可追溯的历史里。
代码可以生成得越来越快。
但为什么做、依据什么做、谁同意它进入下一步,不能跟着一起变得含糊。
这就是我今天把这个项目开源出来的原因。
项目刚起步,欢迎你来看看,也欢迎拿真实流程来挑毛病。
GitHub 开源地址,https://github.com/honghu-ai/sdlc-governance-kit